多智能体 LLM 系统对比:编排、训练出来的委派本能,与会说话的时机
三篇论文各攻克多智能体 LLM 系统的一根轴:Orchestra-o1 定结构,SearchSwarm 把委派训进模型,StreamMA 定通信时机。各自报两位数提升,但数字不能横比。
三篇论文,三个设计问题
多智能体的常见争论是「一个强智能体还是一群弱智能体」。2026 年 6 月发的这三篇论文都跳过了这个争论:它们都默认要用多个智能体,然后各选一个设计轴去优化,并且各自带上了实测数字。
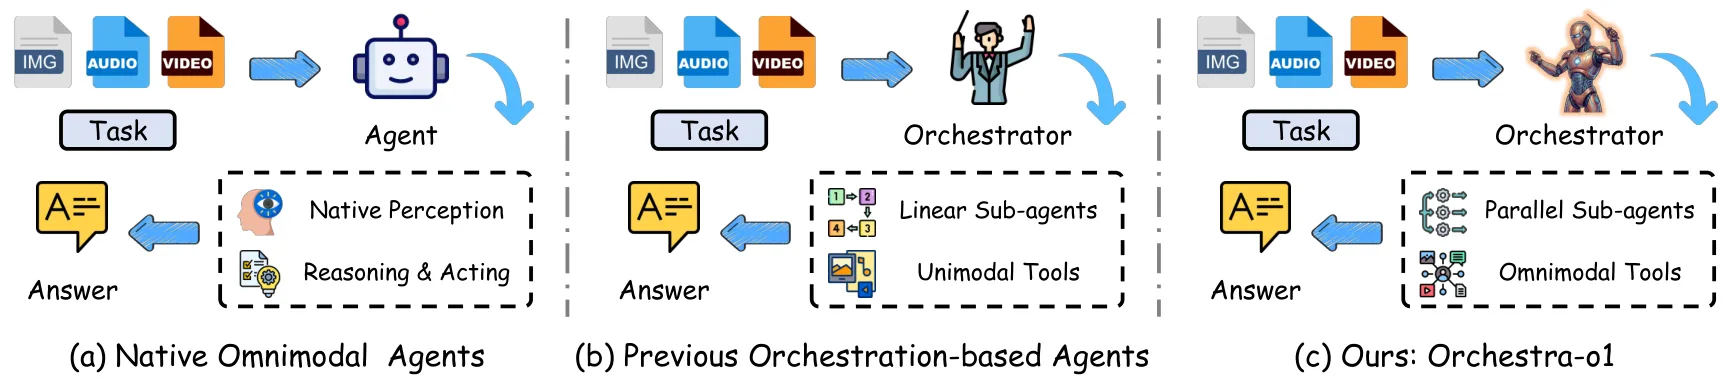
Orchestra-o1 回答谁干什么。一个同时涉及文本、图像、音频、视频的任务,主智能体该怎么拆解、怎么给每个子智能体划定范围、怎么挑后端?它的答案是一张带模态掩码的子目标依赖图,加一个专门训出来的编排器,接 GPT-5 作大脑时在 OmniGAIA 上拿到 72.8%。
SearchSwarm 回答委派能不能训出来。答案是能,前提是训练数据自己造:一个 30B-A3B 模型在 harness 生成的委派轨迹上做 SFT,BrowseComp 从 43.4 跳到 68.1。
StreamMA 回答智能体什么时候该说话。不是等 A 把整条思维链写完再交给 B,而是 A 每写出一个推理步骤就立刻流给 B。结果反直觉:平均精度反而涨 7.3 个百分点,同时最高快 26.9 倍。
三篇合起来正好覆盖了设计空间:结构、技能、协议。这一页用它们各自的数字做对比,并明确标出哪里不能对齐。
关键数字
| 设计问题 | Orchestra-o1 | SearchSwarm | StreamMA | 同一套评测? |
|---|---|---|---|---|
| 优化的轴 | 任务结构(谁干什么) | 委派技能(一个模型会不会拆分工作) | 通信协议(信息什么时候流动) | 不适用,轴不同 |
| 有没有训练? | 在 Qwen3-8B 上用 DA-GRPO 评分奖励训练 | 在过滤后的 harness 委派轨迹上做 SFT | 没有,纯推理时流式 | 不适用 |
| 头条数字 | OmniGAIA 接 GPT-5 得 72.8%;自训 8B 得 30.0% | BrowseComp 68.1,自己的基座 43.4(+24.7) | 对串行多智能体和单智能体基线平均 +7.3 pp | 否,三个不同基准 |
| 最干净的受控提升 | 同一 GPT-5 下比 AOrchestra 高 +32.8(40.0 → 72.8) | 比自己基座高 +24.7(BrowseComp) | HMMT 2026 上 +22.4 pp(Claude Opus 4.6-high) | 只有 SearchSwarm 是同模型对照 |
| 分离机制的消融 | ReAct 12.5 → 框架 26.3 → SFT 28.6 → 朴素 GRPO 27.7 → DA-GRPO 30.0 | 裸委派工具 +2.3;完整 harness +10.0(200 题 BrowseComp 子集) | 流式达到理论流水线加速上界的约 83% | 各自在自己论文内 |
| 效率账目 | 成本 341.6 对 AOrchestra 的 565.7,精度更高(论文自定义成本单位) | 委派本身即上下文压缩,但未报 token 或美元成本 | Stream x4 约 $2.75 对 Serial x16 约 $5.46;64 智能体 × 64 步时墙钟加速 26.9 倍 | 否 |
这张表先看它缺什么:三列之间没有共享基准、共享模型、共享成本单位,所以不存在诚实的「谁是第一」。能比的是三篇主张的形状:每篇都报自己的干预比自己的基线高大约 10 到 33 分,而且每篇都同时给了效率论证,不只是精度。这个形状本身,才是对搭建者有用的信号。
结构:Orchestra-o1 与依赖图
Orchestra-o1 的出发点是:全模态任务(比如看一段视频、读一张图表、回答一个两边都用得上的问题)会压垮单个智能体的上下文和工具箱。于是主智能体先归纳出一张子目标依赖图,每个子目标带两个掩码:模态掩码(文本/图像/音频/视频)和工具掩码。只需要音频分析的子目标完全不碰视频管线,这正是让每个子智能体上下文保持小的机制。
图之上叠三样东西:模态感知分解负责建图;成本感知的匹配分数给每个子任务挑后端,在能力、延迟、价格之间权衡;并行执行把所有无依赖的子任务放在同一委派轮里同时跑,论文证明了轮级加速上界在 1x 到任务数 K 之间。主智能体自己不拿任何工具,上下文只有 24,576 token,重活由每个最多跑 30 步的子智能体干。
训练侧的贡献是 DA-GRPO。朴素 GRPO 只奖励最终答案,对编排来说信号太噪:委派得好也可能答错,委派得烂也可能蒙对。DA-GRPO 把终局奖励换成外部模型(Claude Haiku 4.5)打的评分量表:格式 0.1、动作合法性 0.1、工具合理性 0.2、决策质量 0.6。0.6 压在决策质量上是设计押注:梯度主要追「拆得对不对、派得对不对」,而不是最终字符串对不对。
消融把两层贡献分开了。单框架就把 ReAct 基线从 12.5% 抬到 26.3%,SFT 加到 28.6%,朴素 GRPO 反而掉到 27.7%,只有 DA-GRPO 到 30.0%。也就是说结构贡献 +13.8 分,RL 目标在 SFT 之上只贡献 +1.4;收益大头在架构不在训练。而头条的 72.8% 是框架加 GPT-5 的数字,不是训出来的模型:作者真正训的 8B 得 30.0%,不过在开源全模态智能体里仍居第一(OmniAtlas-Qwen3-30B 是 20.8%)。更能站住的是效率:接同一个 GPT-5,对比上一代编排框架 AOrchestra,精度 72.8% 对 40.0%,成本约为其 60%(341.6 对 565.7,论文自定义单位)。
技能:SearchSwarm 与可训练的委派本能
SearchSwarm 从深度研究的一个痛点出发:长时间搜索任务会把主智能体的窗口塞满原始结果和网页堆砌,常见的补救都是被动的——历史太长就压缩一次,或按固定规则丢掉旧工具输出。SearchSwarm 的替代方案是主动委派:主智能体先拆解任务,通过 call_sub_agent 工具把有边界的子任务派出去,每个子智能体在自己的上下文里跑,只回一份带引用的简短报告。委派本身就是上下文压缩。
麻烦在于,自然文本里几乎找不到显式的多智能体协同,而作者所谓「委派智能」,即什么时候拆、怎么划边界、怎么写任务书、怎么把结果折回主线,没有可爬的训练数据。他们的办法是造:先用一套推理时规则(harness)逼出轨迹(每个子任务必须附任务书和动机,子智能体必须返回引用),再把轨迹过滤成「委派决策正确」的子集,拿去做 Tongyi DeepResearch-30B-A3B 的 SFT。
两个结果比头条更有说服力。第一,harness 单独不起作用:把 harness 跑在未训练的基座上,模型一次 call_sub_agent 都没调用,得分和裸基座一模一样(BrowseComp 43.4)。委派是一种必须训进去的行为,不是提示词能劝出来的。第二,用 DeepSeek V3.2 在 200 题 BrowseComp 子集上的消融显示 harness 的价值在哪:只加裸委派工具,基线框架从 47.7 到 50.0(+2.3);加上完整任务书与引用规则到 57.7(+10.0)。规则扛了大头,而 SFT 让模型自发遵守规则。
训出来的成绩:BrowseComp 68.1 对自家基座 43.4,涨 24.7;另三个榜 BrowseComp-ZH 73.3、GAIA 82.5、xbench-DeepSearch 80.8,全部是 30B-A3B 级别最优。这个技能还迁移:把子智能体工具禁掉,同一个单模型在 200 题子集上仍以 52.0 对 43.5 胜过基座,说明拆解习惯不依赖委派工具。没报的是并行子智能体的 token、墙钟或美元成本,所以「委派比单一长上下文省多少」这个命题,论文断言了但没测。
协议:StreamMA 与说话的时机
StreamMA 只改一个变量:智能体之间通信的时机。默认模式是「写完再传」:A 写完整条思维链才交给 B。StreamMA 把 A 写出的每个推理步骤即时管道给 B,B 在 A 还在想的时候就已经在处理前半段。延迟收益直白而大:最高 26.9 倍墙钟加速(64 智能体、每智能体 64 步的配置),达到理论流水线上界的约 83%。
精度收益才是意外,而论文的解释很锋利:多步推理的质量不均匀。链上早期步骤更可靠,后期步骤累积错误、漂移和过度思考。串行的下游智能体拿到完整链,等于继承了那段易错的尾巴并被带偏;流式智能体先在可靠的前半段上建立自己的势头,等错误尾巴传到时已是有稀释而非照抄。速度和精度来自同一个机制,所以流式不是在拿精度换延迟。
另两个结果补全了协议故事。成本账上,Stream x4 约 $2.75,对比 Serial x16 的约 $5.46,精度更高、价格大约一半。作者还报告了一个「步级扩展律」:固定智能体数量、增加每智能体的推理步数,效果和效率同时改善,且与加智能体这条轴正交、可叠加。不过精度叙事有适用域:它依赖「后期步骤爱出错」这个在长链数学/科学/代码推理里成立的假设;如果任务的结论只在最后一步才出现(长程规划、多跳综合),把前半段流给下游可能恰好丢掉最重要的部分,论文没覆盖这类任务。
三篇论文的共识
并排读,三篇系统在三件事上收敛。第一,分解都赚钱,但赚的机制不同:Orchestra-o1 靠范围隔离(谁也不许多看),SearchSwarm 靠委派即压缩,StreamMA 证明「信息何时到」和「给多少」同样重要。第二,智能体行为的瓶颈是训练数据,而通用的解法是自己造:Orchestra-o1 用评分模型给编排决策打分,SearchSwarm 把 harness 轨迹过滤成 SFT 数据,连不训练任何东西的 StreamMA,其协议也来自对步骤可靠性的闭式分析。第三,每篇都把效率论证和精度论证并列:更准还更便宜(Orchestra-o1 的 341.6 对 565.7)、更准且半价(StreamMA 的 $2.75 对 $5.46),或者至少如实留下空白(SearchSwarm 干脆没报成本,这本身也是个信息)。
怎么选
- 跨模态复合任务、能用前沿闭源 API: Orchestra-o1 的结构。模态掩码子智能体和成本感知后端匹配是可复用的资产;引用 72.8% 时必须带上 GPT-5 后端。
- 一个开源模型必须可靠地委派: 走 SearchSwarm 路线。先建规则 harness,生成轨迹,过滤出委派决策正确的样本,再 SFT。别指望光靠提示词长出委派行为:未训练的基座上一次都没调用子智能体工具。
- 智能体之间传递长推理链、延迟敏感: StreamMA 的流式协议。收益绑在长多步链上;短链单发任务可以跳过,论文自己也承认。
- 结构还没定: 三个都别用。三篇都是在「已经分解好」的设计上量自己的干预,没有一篇回答「你的任务到底该不该多智能体」。
局限与存疑
最根本的局限是可比性:三个基准(OmniGAIA、BrowseComp、数学/科学/代码套件)、三类模型(GPT-5、30B-A3B MoE、Claude Opus 4.6 / GPT-5.4)、三种成本单位,零交集。谁要是排出一张三系统的总名次表,那就是造出了一个没有任何论文做过的对比。
各篇内部的空白也很具体。Orchestra-o1 直接复用 OmniGAIA 而没有审计其污染控制,成本数字没有 token 或墙钟分解,而且 GPT-5 框架成绩(72.8%)和自训 8B(30.0%)之间 42.8 分的差距说明:这套框架今天的价值主要是给前沿闭源模型当外壳。SearchSwarm 的头条成绩旁边站着大它一个数量级的模型,但没报委派成本,它最强的迁移证据(Qwen3-30B-A3B 换装得 66.5)是在 200 题子集上测的,不能直接和完整的 1266 题 BrowseComp 对齐。StreamMA 的精度主张倚重 Claude Opus 4.6-high,且成立的前提是「后期步骤易漂移」这个失效模式;换成更便宜的模型或综合型任务,+22.4 分还剩多少是开放的。三篇的评测也都偏英语短答案智能体基准,对长程自主性的说明力有限。
常见问题
Orchestra-o1、SearchSwarm、StreamMA 哪个多智能体系统最好?
没有实测排名,因为三者在不同基准上回答不同问题。Orchestra-o1 报 OmniGAIA 72.8%(自训 8B 为 30.0%),SearchSwarm 报 BrowseComp 68.1 对基座 43.4,StreamMA 报八个推理基准平均 +7.3 pp。把 72.8、68.1 和 +7.3 当成一个联赛去比没有意义;按你缺的那根轴来选:任务结构、委派技能,还是通信协议。
SearchSwarm 的答案:多智能体委派需要训练吗,还是提示词就够?
SearchSwarm 的证据表明「委派反射」这一点专门需要训练:推理时 harness 在未训练基座上一次都没触发 call_sub_agent,得分与裸基座完全相同。Orchestra-o1 则显示结构层面相反:编排框架不靠任何 RL 就把 ReAct 基线从 12.5% 抬到 26.3%。 把两者调和起来的读法是:分解规则可以靠提示词,但「委派而不是自己干」的习惯,至少在 30B 级别模型上,提示不出来。
Orchestra-o1 的 OmniGAIA 72.8% 是模型能力吗?
不是。72.8% 是把编排框架跑在 GPT-5 后端上得到的,量的是框架加强前沿模型。作者真正训练的模型是一个 8B 编排器(DA-GRPO),得 30.0%,在开源全模态智能体里领先(OmniAtlas-Qwen3-30B 为 20.8%),但离 72.8% 很远。框架的公平对照是同一 GPT-5 下的 AOrchestra:72.8% 对 40.0%,成本约六成。
StreamMA 的答案:智能体之间只传部分推理会掉精度吗?
在 StreamMA 的设置里反而涨。八个基准上,流式同时超过串行多智能体和单智能体基线,平均 +7.3 pp,在 HMMT 2026(Claude Opus 4.6-high)上峰值 +22.4 pp。提出的机制是:早期推理步骤比后期可靠,下游智能体从可靠的前半段开工,就避免了继承易错尾巴。适用域的保留也一样重要:结论只在最后一步才出现的任务,流式前半段可能恰好丢掉关键信息。
多智能体委派比单智能体贵多少?
三篇里只有两篇给了数。StreamMA 报 Stream x4 约 $2.75,对比 Serial x16 的约 $5.46,精度更高、约半价,64×64 配置下墙钟最高加速 26.9 倍。Orchestra-o1 报自家框架成本 341.6,同一 GPT-5 下旧编排框架 AOrchestra 为 565.7(自定义单位)。最纯的委派系统 SearchSwarm 反而没报并行子智能体的任何 token、墙钟或美元成本,所以它相对单一长上下文是否划算,仍未被测量。