流式与长视频理解对比:X-Stream 对决 V-RAGBench,全看还是只取所需
X-Stream 测同时看几路直播(最强 49.60%,人类 91.84%);V-RAGBench 测长视频检索(Recall@5 0.603 对 0.510)。
为什么长视频和流式视频让旧评测玩法失效
短视频问答曾经是个看起来被解决了的问题:取 30 秒片段,把每一帧都塞进上下文窗口,让强模型直接答。这套玩法在视频长达一小时、或是直播不能回放、或是几路画面同时进来的时候彻底失效。2026 年真正诚实的问题不再是”在某个数据集上再高一个点”,而是:证据散落在一股你无法完整重读的流里,系统的上下文预算比视频还小的时候,它怎么办。
watch-remember-reason 综述给这篇对比提供了地图。它的主张是:别再按数据集给论文分类,改按模型真正要做的事分类:watch(从视频流里获取证据)、remember(跨分钟乃至小时保留上下文)、reason(给出有依据的回答)。综述把 100 多个方法挂进这个骨架,并明确指出流式第一视角理解是尚未解决的前沿,下面两篇基准论文压测的恰恰是同一个区间。
这三篇里有两篇给出了可信的基准,它们的存在都是因为作者发现旧评测在撒谎,只是撒谎的方向相反:一个让模型从没同时看多路画面却显得很行,另一个让模型从不检索任何东西却能拿高分。
X-Stream:有模型能同时看几路直播吗?
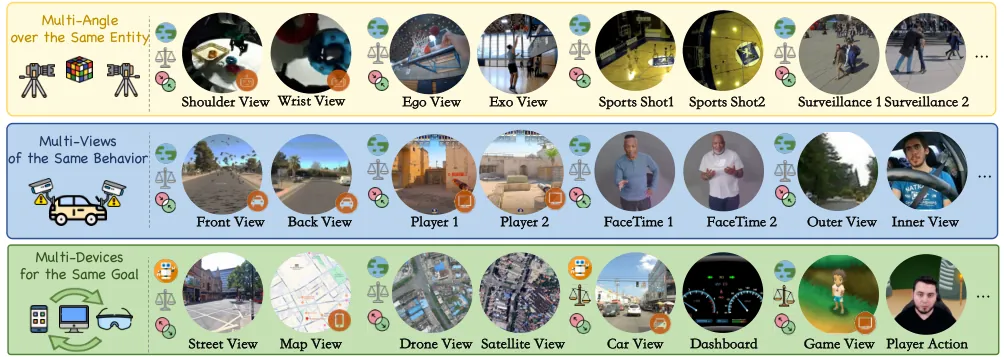
X-Stream是第一个并发多流理解基准:不是一段视频,而是几路同时直播的画面,模型必须边看边跨流推理:多窗口桌面、多机位场景、多设备摄像头流。它贡献了 932 段视频上精选的 4,220 条问答、11 个子任务,并给出了一个干净的概念视角:把多模态大模型当作需要在并发信号之间分拣调度的复用器。
答案是明确的不。最强模型 Gemini 3 Pro 总分只有 49.60%,而人类标注员是 91.84%,42 个点的差距,靠扩大生成规模没能填上。GPT-5 只有 27.78%,GPT-4o 22.46%,所有开源模型都落在 6% 到 34% 之间。专门为流式视频设计的架构反而最差:Dispider 15.44%,VideoLLM-online-8B 8.48%,MMDuet2 6.79%。为单流在线视频打磨的模型不仅没做好并发,甚至比通用前沿模型输得更惨。
子任务分解定位了失败点。即便 Gemini 3 Pro,因果推理也只有 41.79%、决策 44.18%,较容易的 visual grounding 是 66.72%。主动性能力(不被提示、在对的时刻跨流做出反应)大多数模型不到 21%。这才是监控员、直播分析师、多摄像头机器人真正需要的能力,而单流基准从来没人测过它。
V-RAGBench 与 CARVE:看不完的视频,只能靠检索
与之互补的是另一类视频:根本不可能完整看完的那种。V-RAGBench 和 CARVE从一个令人不安的发现出发:在常用的视频问答基准里,超过一半的查询根本不需要看视频就能答对,靠语言先验、世界知识或静态画面提示就够。这类基准在悄悄奖励那些从不检索的”检索系统”。
V-RAGBench 就是来堵这个洞的。它从 216 段第一视角视频取材(Ego4D 174 段、平均 86 分钟,EgoLife 42 段、平均 379 分钟;时长 11 到 99 小时),候选查询要连过五道过滤:语义相似去重、可答性验证、捷径偏差消除(不看画面也能答的题直接丢弃)、经验可答性确认、证据唯一性检查。最终留下 2,100 条带标注证据块的查询/证据/答案三元组(1,800 训练、300 测试),每条都标着证据块,因此检索和生成分开打分:检索看 Recall@5 和 nDCG@5,生成看 LLM 评判的通过率。
配套的 CARVE 方法并行跑四个检索器(每种”模态×粒度”配置一个),让每个视频块带着找到它的最优配置进入生成端。数字如下:
- Recall@5 0.603,对最强基线 VideoRAG-A 的 0.510(八个基线里最好)。
- nDCG@5 0.433,对同指标最好基线的 0.340。
- 生成通过率 0.357(配 Qwen3-VL-8B,最好基线 0.315);换 Qwen3-VL-32B 是 0.367 对 0.317,换 Gemma-4-26B 是 0.320 对 0.307,检索增益在三个不同生成器上都成立。
消融实验讲清了增益从哪来,也是最值得抄的部分:单一最优配置只有 0.507;两配置的部分组合到 0.567;四个配置加按块选择到 0.603。所以关键不是”检索器多”,而是最优配置是块内容的属性,不是查询的属性;按查询固定一个配置的行业惯例白白丢了召回。让每个块只在自己那个配置下重排序是承重的:随机指派配置或把所有配置拼接成联合打分,Recall@5 都掉到 0.513。而且这套手工按块规则还赢了训练出来的路由(通过率 0.357,对训练过的非 LLM 路由器 0.329、LoRA 微调过的 LLM 路由器 0.310),全程零训练。
两种失败模式互为镜像,这才是真故事
两篇文章并排读,描述的是同一堵墙的两侧。X-Stream 说明:把完整视频给前沿模型、只是要求它一次看更多路,它照样失败:49.60% 对人类的 91.84%,主动多流场景大多数人模型不到 21%。V-RAGBench 说明:放弃全看、改走检索,检索本身也很脆,即便是最好的管线,top-5 里找不到正确证据的概率仍有约四成,而这类视频本来也不可能塞进上下文。
两边的数字不能直接互比:任务、口径、指标都不同,V-RAGBench 刻意防泄漏的设计也让它的绝对分比老式视频问答榜单更苛刻。诚实的跨论文结论更窄也更有用:“全看”和”只取所需”两条路现在都还在输,而且输的方式可以精确指出;任何假设其中一条路已经解决的产品设计,都会带着已知的失败面上线。这也正是 watch-remember-reason 分解的要点:两个基准分别攻 watch 和 remember 两根支柱,谁也没碰到 reason 那根的可信度问题。
关键数字
| 维度 | X-Stream | V-RAGBench / CARVE | 能否直接比 |
|---|---|---|---|
| 测什么 | 并发多流观看加跨流推理 | 11-99 小时第一视角视频上的检索 | 任务不同 |
| 规模 | 4,220 条问答、932 段视频、11 个子任务 | 2,100 条三元组、216 段视频(1,800 训练/300 测试) | / |
| 最好成绩 | Gemini 3 Pro 总分 49.60% | CARVE Recall@5 0.603 | 不能直接比 |
| 参照点 | 人类基线 91.84%(差 42.2 个点) | 最好基线 VideoRAG-A 0.510(差 0.093) | / |
| 主动/最难维度 | 主动性多数模型不到 21%;因果 41.79%、决策 44.18%(Gemini 3 Pro) | 生成通过率 0.357(Qwen3-VL-8B) | / |
| 专用系统 | Dispider 15.44%、VideoLLM-online-8B 8.48%、MMDuet2 6.79% | 单一最优配置 0.507;随机指派 0.513 | / |
同口径消融(各论文内部同 harness):
| 对比 | 得分 | 设置 |
|---|---|---|
| CARVE 四配置按块选择 | 0.603 Recall@5 | V-RAGBench 测试集 |
| CARVE 两配置部分组合 | 0.567 Recall@5 | 同口径 |
| CARVE 单一最优配置 | 0.507 Recall@5 | 同口径 |
| 随机配置/联合拼接 | 0.513 Recall@5 | 同口径 |
| CARVE 规则 对 训练路由器(非 LLM / LoRA LLM) | 0.357 / 0.329 / 0.310 通过率 | Qwen3-VL-8B 生成器 |
怎么选
要评测前沿模型的多流就绪度 → 用 X-Stream。 如果你的产品涉及两路以上的并发画面(多摄像头、多窗口、多设备),单流视频问答的数字几乎不说明问题。X-Stream 的 11 个子任务和主动性切片,是目前最接近”这个模型能不能当直播操作员”的公开度量。
要在小时级第一视角视频上做问答 → 用 CARVE 式按块检索管线。 经得起消融考验的配方是:多种模态×粒度配置并行,每个块按”谁检索到它”分配配置,只在那个配置下重排。但要对诚实的工作点有预期:Recall@5 大概在 0.6 附近而不是 0.9,产品设计要为”找不到证据”留后路。
要评测任何检索管线 → 先防泄漏,照 V-RAGBench 来。 如果你的评测查询里超过一半不看视频也能答对,你的榜单测的是语言先验。五道过滤(捷径消除加证据唯一性)比 CARVE 方法本身更值得搬走。
要摸这个领域的全貌 → 看 watch-remember-reason 综述。 三篇里只有它没有新数字,它也不假装有;用它来先给方法论文归位,再决定要不要信它们的基准宣称。
局限与存疑
两个基准都是 2026 年中模型的快照,而 X-Stream 上模型之间的差距(Gemini 3 Pro 49.60%、GPT-5 27.78%)会随前沿模型换代而收缩。V-RAGBench 的限制是结构性的:证据落在互不重叠的 2 分钟块里,证据跨块或跨越长区间的查询不在范围内,知识图谱和元数据检索整个被搁置。CARVE 每条查询要跑四个检索器加一个重排器,论文只谈质量收益、不给延迟和成本预算,对更便宜的固定配置到底值不值,没有量化答案。两篇还都依赖特定评审模型(过滤用 GPT-5.2-chat、通过率为 LLM 评判),这些数字在多大程度上依赖评审模型本身,原文没有展开。
两篇都没回答的开放问题:“全看”和”只取所需”能不能组合。还没有人在 X-Stream 式的多流负载上,给前沿模型接上 CARVE 式检索,要在延迟预算内、带主动触发地跨并发直播流检索。这恰恰是 watch-remember-reason 综述点名的未解决区间,谁先把这套基准做出来,谁才算真正测到了流式视频理解的终点。
常见问题
X-Stream 和 V-RAGBench 哪个更难?
它们压测的东西不同,分数不能直接比。X-Stream 的头条差距是同一批 4,220 条问答上模型与人类的差距:最强模型 Gemini 3 Pro 得 49.60%,人类基线 91.84%。V-RAGBench 的头条差距是检索系统之间的差距:在 2,100 条防泄漏三元组上,CARVE 的 Recall@5 是 0.603,最好基线 0.510。前者测模型到底能不能同时看并发流,后者测检索在看不完的视频里找不找得到证据。
多模态大模型能同时看多路视频吗?
截至 X-Stream 的评测,基本不能。最强模型 Gemini 3 Pro 在 4,220 条多流问答上总分 49.60%,人类标注员是 91.84%;主动反应能力(不被提示、在对的时刻行动)大多数模型不足 21%。专门的流式架构反而最差:Dispider 15.44%、VideoLLM-online-8B 8.48%、MMDuet2 6.79%。
CARVE 的 Recall@5 0.603 是对什么测出来的?
是在 V-RAGBench 上测的:这是 216 段 11 到 99 小时第一视角视频、2,100 条带标注证据的查询/证据/答案三元组组成的防泄漏基准。CARVE 的 0.603 对的是八个基线中最强的 VideoRAG-A 的 0.510;因为每条查询的证据块都有标注,检索分数与生成分数分开计算。
V-RAGBench 为什么要把一半的典型视频问答查询过滤掉?
因为 CARVE/V-RAGBench 的作者发现:常用视频问答基准里超过一半的查询不看视频也能答对,靠语言先验、世界知识或静态线索。这类查询会把生成准确率灌高、同时掩盖检索的失败,所以 V-RAGBench 设了五道过滤(含捷径偏差消除和证据唯一性检查),最终只留下 2,100 条三元组。
watch-remember-reason 综述和这两个基准是什么关系?
综述是地图,不是测量。它把 100 多个长视频方法组织成 watch、remember、reason 三种能力,并把流式第一视角理解点名为开放前沿。X-Stream 和 V-RAGBench 各测其中一根支柱(并发下的 watch、以检索实现的 remember),综述则解释了为什么第三根支柱,即对”真正看到的内容”保持忠实的推理,是三者中最难测的。