LLM RL 与蒸馏的信赖域方法:CPPO、TrOPD、TRB 对比
CPPO 收紧早期 token 裁剪(AIME 比 DPPO 高 5.56),TrOPD 逐 token 判断老师可信度(稳定高 3 分上下),TRB 预热期在 KL 信赖域内混合老师行为。
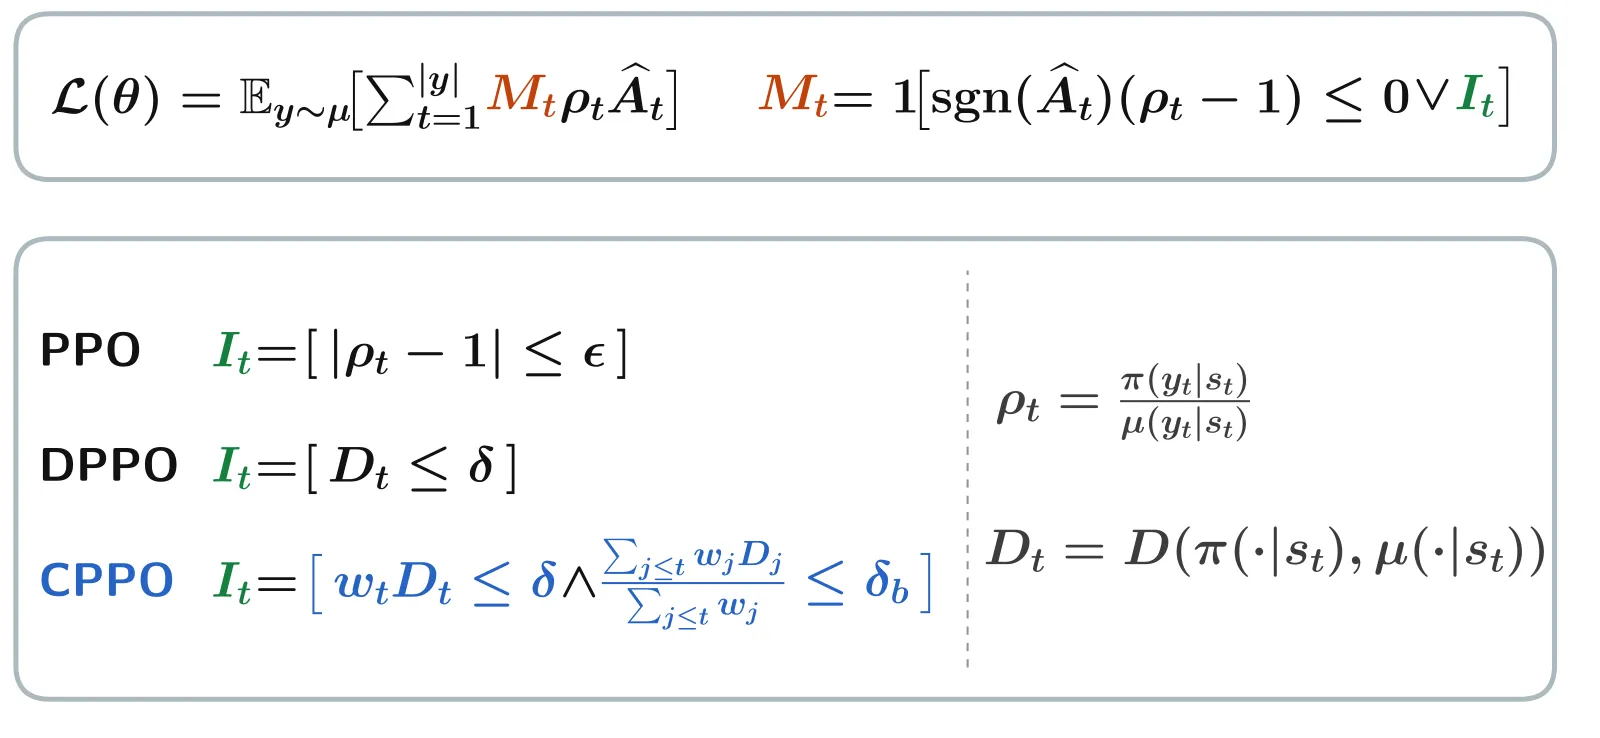
同一个思想,搬到三个不同的故障点
PPO 的裁剪本质是一个信赖域:限制每次更新能把策略推多远,让坏梯度掀不翻训练。多年来这个边界对每个 token 一视同仁、也不记历史。2026 年中的三篇论文认为,统一信赖域方向对、但在三个不同地方同时错了,各自修了一处:
- CPPO(累计前缀散度策略优化)修的是 RL 里的裁剪规则:自回归链里靠前的 token 单位偏移造成的破坏更大,所以它们该配更紧的阈值;而一个出现在已经漂移过的前缀之后的 token,该拿到的额度本来就比跟在干净前缀后的少。
- TrOPD(信赖域在策略蒸馏)修的是蒸馏里的信用分配:老师只在它给的概率不低于学生的地方是可靠监督者,所以信赖域应该逐 token 决定老师的梯度有没有资格驱动这次更新。
- TRB(信赖域行为混合)修的是预热阶段的采样来源:训练早期学生的采样太弱,老师把监督浪费在纠正”学生练好了根本不会产生的前缀”上,所以预热期的 rollout 该来自”离老师最近、同时又落在以学生为中心的 KL 信赖域内”的策略。
同一个数学直觉,三处互不重叠的干预。三篇论文彼此都没有评测对方,所以这篇对比是三套独立证据的拼合,不是同台打擂。
CPPO:信赖域应该记住前缀
PPO 一系的推理 RL(GRPO、DAPO、DPPO 等)对每条序列的每个 token 用同一个裁剪阈值。CPPO 的诊断(有 Figure 2 的实测支撑)是这忽略了自回归生成真实的失效方式:第 5 个 token 出错会改变其后一切的生成条件,实测策略偏移在早期位置更大、尾巴更重,而只看单个 token 的阈值对前缀已经漂了多远毫无记忆。CPPO 把这两个盲区命名为自回归不对称和累计前缀漂移。
修法有两个旋钮。线性位置权重从首个 token 的 1.0 衰减到末位的 w_min = 0.8,有效阈值 δ/w_t 前紧后松。累计前缀预算维护前缀散度的加权累计和 S_t,一旦推某个 token 会超出 δ + δ_b·W_{t-1} − S_{t-1} 就屏蔽它。也就是说,一个 token 会因为”自己偏太多”或”前面的前缀已经超支”而被杀掉。目标函数、奖励、数据全都不动,只换裁剪规则。
消融实验是全文最有信息量的部分:去掉任何一个旋钮仍胜过 DPPO,说明两个部件都不是摆设;而 shuffle 测试最能说明问题——保持阈值数值不变、只打乱位置权重的顺序,效果变差,这就排除了”只是平均裁剪更紧了”这种解释。想了解为什么最近的推理 RL 增量都出在裁剪规则上,见 GRPO vs PPO。
TrOPD:信赖域应该决定老师在哪儿可信
在策略蒸馏(OPD)让学生在自己的采样上向更强的老师学习。它已知的失效模式是离群 token:当学生生成一个老师认为极不可能的 token,逆向 KL 会产生一个又大又 noisy 的梯度,把学生推下悬崖而不是纠正它。推理恰恰依赖难 token 的探索,所以不稳定最严重的位置正是最关键的位置。
TrOPD 的做法是逐 token 的信任比率 P_trust(x) = min(老师概率 / 学生概率, 1)。信任域内照常做在策略蒸馏;离群 token 上,把不稳定的逆向 KL 梯度换成老师对 top-k 词表的前向 KL 目标,既不盲信坏梯度,也不简单屏蔽归零。另有一个很轻的非在策略项(beta = 0.001,退火到零),让学生早期模仿老师写的前缀,等自己的 rollout 值得学习为止。
这个设计是信用分配,不是新的损失函数族:逐 token 判断老师是否赢得了驱动梯度的资格。所有改动都挂在现有 OPD 之上,这是它便宜的原因。
TRB:信赖域该管采样来源,不该管损失
TRB 针对的 OPD 问题和 TrOPD 不同。就算 OPD 稳定,它的预热阶段也是浪费的:学生很弱,自己采样的前缀质量低,老师把监督花在教学生续写”一个有水平的学生根本不会写出的前缀”上。在数学推理这类一个早期坏 token 就毁掉整条链的任务上,这是主动的伤害。
TRB 只改预热期前缀的来源,不改损失。行为策略是”离老师最近、同时又落在以学生为中心的 KL 界内”的策略,所以早期前缀既有水平、又分布得足够近,学生真能学到。随后 KL 预算退火到零,控制权交还给纯学生 rollout;逐前缀逆向 KL 蒸馏目标从头到尾未被修改。论文对结果的表述很克制:在两个数学推理蒸馏设定中取得对比方法里的最强平均,是训练配方的改进,不是能力声明。与前两篇不同,TRB 的具体分数在摘要级别的资料里拿不到,所以增益幅度在这里按未验证处理。
关键数字
三篇论文的实验设置互不相同,所以下表没有任何一格是同台对比;每一行都是单篇论文内部同口径的对照。
| 测量项 | 最优信赖域方法 | 主要基线 | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| AIME24/25/26 Avg@16 | CPPO 54.79 | DPPO 49.23(+5.56)、GRPO 38.19(+16.6)、MinPRO 48.12 | Qwen3-30B-A3B-Base,CPPO | 是,CPPO 论文内部 |
| AIME 族,较小规模 | CPPO 四个设定全胜 | 对第二名的优势 3.06、0.91、1.39、5.56 | Qwen3-1.7B 31.88、1.7B-Base 12.78、8B-Base 31.11 | 是 |
| 数学单域平均 | TrOPD 49.85 | OPD 46.79(+3.06)、REOPOLD 47.86 | AIME24 38.54 对 35.83,AIME25 32.50 对 29.16,AMC23 78.51 对 75.39;TrOPD 表 1 | 是 |
| 多域平均,1.5B 学生 | TrOPD 40.63 | OPD 37.11(+3.52) | DeepSeek-Qwen2.5-1.5B,数学+代码+STEM;GPQA 36.24 对 28.03 是最大单项提升 | 是 |
| 多域平均,1.7B 学生 | TrOPD 51.73 | OPD 48.29(+3.44) | Qwen3-SFT-1.7B,覆盖数学、STEM、指令跟随、代码 | 是 |
| 数学蒸馏,两个设定 | TRB 最强平均 | 对比的各类 OPD 方法 | 无公开分数;幅度按摘要级资料未验证 | TRB 论文内部 |
| 训练后期行为 | TRB 退化为标准 OPD | 构造上如此 | KL 预算预热后退火到零 | 是,由设计决定 |
逐行看这张表,一个事实最突出:CPPO 和 TrOPD 的优势是”稳”而不是”爆”。CPPO 的最大优势(+5.56)落在唯一用了非默认阈值(δ 0.2 对稠密模型的 0.15)的 MoE 设定上,小规模的优势缩到 1.5 分以内。TrOPD 的优势几乎纹丝不动:+3.06、+3.52、+3.44 横跨三套设定,这正是训练稳定性声明该有的样子。TRB 那一行对它的局限很诚实:平均最优,但没有可引用的分数。
三者的共性,与不同
三者都是 rollout 或梯度侧的干预,底层的优化目标原封不动。CPPO 改的是 PPO 一族损失里的裁剪掩码;TrOPD 改的是哪些 token 拿 OPD 梯度、哪些 token 换成前向 KL 替代;TRB 改的是预热期谁写前缀,逆向 KL 损失保持原样。三者也都在已经调好的配方之上加了超参:CPPO 加 δ_b 和 w_min,TrOPD 加信任门和 beta = 0.001 的非在策略权重,TRB 加初始 KL 预算和退火日程。
差异决定采用方式。CPPO 是 RL 方法,评的是基座模型的 RL 训练,需要奖励和可验证答案。TrOPD 是蒸馏方法,需要比学生强的老师和蒸馏管线,且全部验证在 1.5B 到 1.7B 学生、4B 到 7B 老师的规模上。TRB 是现有 OPD 跑法的预热补丁,只要一个退火日程,但三篇里证据最薄:两个数学设定,没有公开分数,新增超参的敏感性未测。旁边的 Flow-DPPO 把同样的信赖域直觉搬到了 flow-matching 生成上,说明这个思想家族能迁移,尽管没有任何一个方法的数字能直接迁移。
怎么选
方法要对着你真实观察到的故障来选。跑 GRPO 或 DPPO 做长链推理,出现不稳定、奖励尖峰后回落、或长期封顶:选 CPPO,它只换裁剪规则,旗舰设定上对 DPPO 有 +5.56、对 GRPO 有 +16.6,而且它的消融告诉你即使只吸收”早期 token 加权”的直觉该期待什么。跑在策略蒸馏,故障是难 token 上梯度爆炸:选 TrOPD,三套设定稳定在约 3 分,最大单项提升出现在 GPQA,正是 OPD 最弱的分布外 token。OPD 已经稳定、但怀疑前期监督被浪费:TRB 是三者中最便宜的实验,它靠退火自我关闭,不需要任何额外数据。不确定是哪种故障,就先插桩:按 CPPO Figure 2 的做法记录逐 token 偏移随位置的分布,再决定。
局限与存疑
最大的保留是:这里的任何东西都没有跨论文复现过。CPPO 只有数学、全是 Qwen3,最大优势出自最不标准的配置。TrOPD 只做后训练、学生规模小,而且没有消融把信任门、离群前向 KL、非在策略预热三者的贡献拆开,这 3 分里各占多少不得而知。TRB 证据最薄:两个数学设定、无公开分数、新增超参敏感性未测。三者都没有代码、智能体或开放式生成的结果。机制层面的主张,即信赖域应该结构化而非一律,证据充分;任何一个具体结构能广泛获胜,尚未成立。关于在策略蒸馏这个实践本身的大背景,见在策略蒸馏解读。
常见问题
LLM 强化学习里的信赖域是什么?
对单次更新能把策略推多远的一个界,通常实现为裁剪新旧 token 概率之比。PPO 提出了它,GRPO 保留裁剪、去掉了价值模型。本页这三篇 2026 年的论文保留这个思想,但拒绝”每个 token 配同样的界”这个假设。
CPPO 在 AIME 上比 GRPO、DPPO 高多少?
在 Qwen3-30B-A3B-Base 上,AIME24/25/26 Avg@16,CPPO 得 54.79,DPPO 49.23(+5.56),GRPO 38.19(+16.6),MinPRO 48.12。CPPO 还赢下全部四个模型设定,不过小规模上对第二名的优势缩到 0.91 和 1.39 分。
TrOPD 比标准在策略蒸馏好多少?
TrOPD 把平均分提高 3.06 分(单域数学,49.85 对 46.79)、3.52 分(DeepSeek-Qwen-1.5B 多域蒸馏,40.63 对 37.11)、3.44 分(Qwen3-SFT-1.7B,51.73 对 48.29)。最大的单项提升是 GPQA,36.24 对 28.03。
TRB 是蒸馏的新损失函数吗?
不是。TRB 对标准的逐前缀逆向 KL 在策略蒸馏损失一字未改,只改预热期 rollout 的来源:在以学生为中心的 KL 信赖域内采样离老师最近的策略,然后把 KL 预算退火到零,让训练回到纯学生 rollout。
三个信赖域方法先试哪个?
看你遇到了哪种故障。可验证长链任务上 RL 不稳或封顶:CPPO,只换现有损失里的裁剪规则。在策略蒸馏在难 token 上不稳:TrOPD 的逐 token 信任门。OPD 稳定但早期监督看着被浪费:TRB 这个自我关闭的预热补丁。三者的试点成本相对一整轮训练都很低,也都未在自己的基准家族之外被证明。
一句话:统一信赖域曾是默认;2026 年的教训是要给它结构——序列前段收紧、按老师可靠性逐 token 门控、或者放在采样来源而非损失上。原文:CPPO、TrOPD、TRB。